深入理解计算机系统学习笔记-第2章
条评论本篇文章是对《深入理解计算机系统(第三版)》的学习笔记,对一些重点概念和图表做记录,以及写下一些自己的理解,从而使自己更轻松的掌握这门知识。通过对这本书的深入学习,并且完全理解底层计算机系统以及它对应用程序的影响,那么离成为“大牛”就不远了:
- 该教材系统地介绍了整个计算机系统的工作原理,可帮助学生系统性地理解计算机如何执行程序、存储信息和通信;
- 该教材非常强调实践,全书包括9个配套的实验,在这些实验中,学生需要攻破计算机系统、设计CPU、实现命令行解析器、根据缓存优化程序等,在新鲜有需的实验中理解系统原理,培养动手能力;
- 该教材紧跟时代的发展,加入了x86-64指令集、Intel Core i7的虚拟地址结构、SSD磁盘、IPv6等新技术内容;
- 该教材从程序员的角度看待计算机系统,重点讨论系统的不同结构对于上层应用软件编写、执行和数据存储的影响,以培养程序员在更广阔空间应用计算机系统知识的能力。
信息的表示和处理
现代计算机存储和处理的信息以二值信号表示(更加前沿的还有量子计算机)。这些微不足道的二进制数字,或者称为位(bit),形成了数字革命的基础。相比十进制,对二值信号进行存储和执行计算的电子电路更加简单和可靠,制造商能够在一个单独的硅片上集成数百万甚至数十亿个这样的电路。
当我们把这些二进制的位组合在一起,再加上某种解释(inter-pretation),即赋予不同的可能呢位模式以含义,我们就能够表示任何有限集合的元素。
我们这里讨论三种最重要的数字表示:
- 无符号(unsigned)编码基于传统的二进制表示法,表示大于或者等于零的数字。
- 补码(two’s-complement)编码是表示有符号整数的最常见的方式,有符号整数就是可以为正或者为负的数字。
- 浮点数(floating-point)编码是表示实数的科学记数法的以2为基数的版本。
计算机用这些不同的表示方法实现算术运算,例如加法和乘法,类似于对应的整数和实数运算。
计算机的表示法式用有限数量的位来对一个数字编码,因此,当结果太大以至于不能表示时,某些运算就会溢出(overflow)。
信息存储
大多数计算机使用8位的块,或者字节(byte),作为最小的可寻址的内存单位,而不是访问内存中单独的位。机器级程序将内存视为一个非常大的字节数组,称为虚拟内存(virtual memory)。内存的每个字节都由一个唯一的数字来标识,称为它的地址(address),所有可能地址的集合就称为虚拟地址空间(virtual address space)。
C语言中一个指针的值都是某个存储块的第一个字节的虚拟地址。C编译器还把每个指针和类型信息联系起来,这样就可以根据指针值的类型,生成不同的机器级代码来访问存储在指针所指向位置处的值。
尽管C编译器维护着这个类型信息,但是它生成的实际机器级程序并不包含关于数据类型的信息。每个程序对象可以简单地视为一个字节块,而程序本身就是一个字节序列。
十六进制表示法
一个字节由8位组成。在二进制表示法中,它的值域是00000000~11111111。如果看成十进制整数,它的值域就是0~255。
两种符号表示法对于描述位模式来说都不是非常方便。二进制表示法太冗长,而十进制表示法与位模式的互相转化很麻烦。替代的方法是,以16位基数,或者叫做十六进制(hexadecimal)数,来表示位模式。十六进制(简写为“hex”)使用数字‘0’~‘9’以及字符‘A’~‘F’来表示16个可能的值。
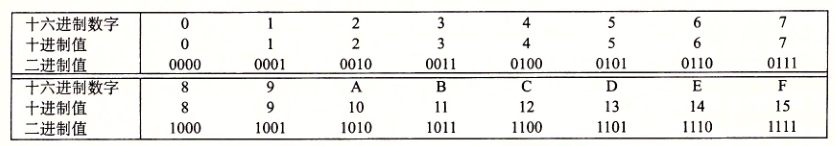
在C语言中,以0x或0X开头的数字常量被认为是十六进制的值。字符‘A’~‘F’即可以是大写,也可以是小写,甚至是大小写混写。
编写机器级程序的一个常见任务就是在位模式的十进制、二进制和十六进制表示之间人工转换。
十六进制与二进制之间的转化,可以以4位为一组逐个进行转化。最左边一组不足4位的,需要补0。
例如:
- 0x39A7F8,可转化为0011 1001 1010 0111 1111 1000
- 1100100101111011,可转化为0xC97B
- 0xD5E4C,可转化为1101 0101 1110 0100 1100
- 1001101110011110110101,(最左边补2个0)可转化为0x26E7B5
十六进制与十进制之间的转化,较为方便的方法是次幂或整除。
例如:
- 十六进制转化十进制,给定十六进制数字0x7AF,我们可以用相应的16的幂乘以每个十六进制数字,即十进制数字为7·16²+10·16+15=1967
- 十进制转化十六进制,给定十进制数字314156,我们可以对其除16,所得余数从尾到头依次排列可得十六进制数字。
314156÷16=19634…12 得C
19634÷16=1227…2 得2
1227÷16=76…11 得B
76÷16=4…12 得C
4÷16=0…4 得4
即十六进制数字为0x4CB2C
字数据大小
每台计算机都有一个字长(word size),指明指针数据的标称大小(nominal size)。因为虚拟地址是以这样的一个字来编码的,所以字长决定的最重要的系统参数就是虚拟地址空间的最大大小。也就是说,对于一个字长为w位的机器而言,虚拟地址的范围为0~2^w-1,程序最多访问2^w个字节。
- 32位字长限制虚拟地址空间为4千兆字节(即4GB),即4·10^9字节
- 64位字长的虚拟地址空间能达16EB,即1.84·10^19字节
大多数64位机器也可以运行为32位机器编译的程序,这是一种向后兼容。
即,使用32位编译的程序能够同时在32位和64位机器上运行,而使用64位编译的程序则只能够在64位机器上运行。
计算机和编译器支持多种不同方式编码的数据格式,如不同长度的整数和浮点数。比如,许多机器都有处理单个字节的指令,也有处理表示为2字节、4字节或8字节整数的指令,还有些指令支持表示为4字节和8字节的浮点数。
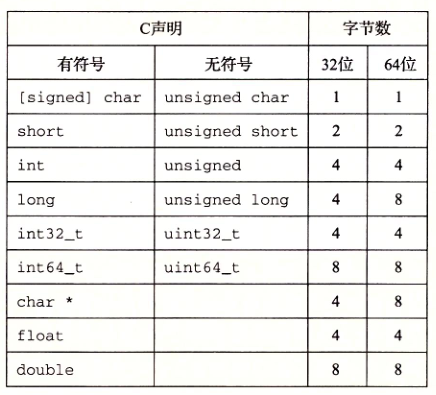
程序员应该力图使他们的程序在不同的机器和编译器上可移植。可移植性的一个方面就是使程序对不同数据类型的确切大小不敏感。
寻址和字节顺序
对于跨越多字节的程序对象,我们必须建立两个规则:这个对象的地址是什么,以及在内存中如何排列这些字节。
在几乎所有的机器上,多字节对象都被存储为连续的字节序列,对象的地址为所使用字节中最小的地址(如:C指针指向数组或结构体的开头地址)。
排列表示一个对象的字节有两个通用的规则:一种是最低有效字节在最前面的方式,称为小端法(little endian)。另一种是最高有效字节在最前面的方式,称为大端法(big endian)。
大端法在感官上比较符合我们日常从左到右的阅读顺序,而大多数Intel兼容机都只用小端模式。
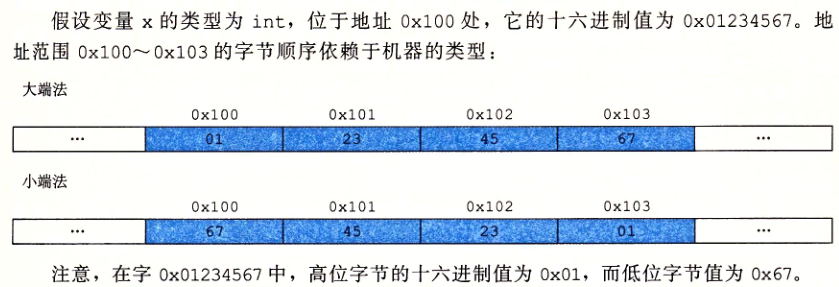
在字0x01234567中,高位字节的十六进制值为0x01,而低位字节值为0x67
许多比较新的微处理器是双端法(bi-endian),也就是说可以把他们配置成作为大端或者小端的机器运行。然而,实际情况时:一旦选择了特定操作系统,那么字节顺序也就固定下来。
Linux、Windows、Android、IOS等操作系统,几乎都是小端模式
字节顺序为什么重要?
第一种情况是,在网络传输时,可能同时存在大端和小端模式的机器,此时为避免出现网络发送/接收的字节顺序相反的情况,网络应用程序的代码编写必须遵守已建立的关于字节顺序的规则,以确保发送机器将它的内部表示转换成网络标准,而接收方机器则将网络标准转换为它的内部表示。
第二种情况是,当阅读表示整数数据的字节序列时字节顺序也很重要。这通常发生在检查机器级程序时(如汇编程序,或反汇编器disassembler生成的程序)。
第三种情况是,当编写规避正常的类型系统的程序时。例如,在C语言中,可以通过使用强制类型转换(cast)或联合(union)来允许以一种数据类型引用一个对象,而这种数据类型与创建这个对象时定义的数据类型不同。
对于第三种情况,我这里给出了一段代码示例:
1 |
|
示例代码中,我们首先定义了show_bytes函数。该函数能够将传入的参数,以十六进制来打印出其在内存存放的数据值。
show_int、show_float分别表示打印出整型、浮点型的内存数据值,而show_pointer则表示打印出指针存放在内存中的值(即指针所指向的地址)。
1 | // val == 12345 |
分别在以下机器上运行示例代码,val值为12345:
- Linux 32:运行Linux的Intel IA32处理器
- Windows:运行Windows的Intel IA32处理器
- Sun:运行Solaris的Sun Microsystems SPARC处理器
- Linux 64:运行Linux的Intel x86-64处理器
结果分别如下:
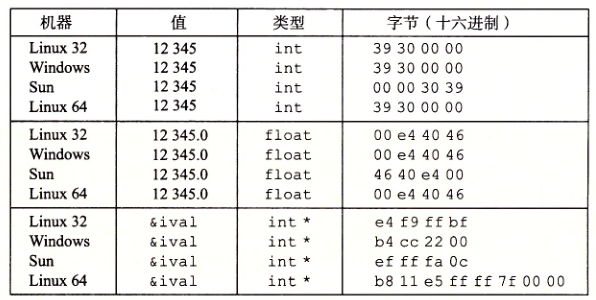
参数12345的十六进制表示为0x00003039。我们可以看出只有Sun是大端法表示,其他系统的都是小端法表示。另外,还有需要注意的是,Linux 32、Windows和Sun的机器使用4字节地址,而Linux 64使用8字节地址。而且指针的值是不相同的,因为不同的机器/操作系统配置使用不同的存储分配规则。
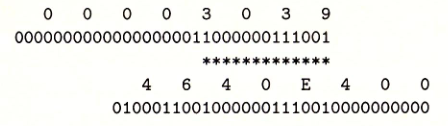
针对整数和浮点数对数值12345编码的不同,整型为0x00003039,浮点型为0x4640E400。一般而言,这两种格式使用不同的编码方法。如果我们将这些十六进制模式扩展为二进制形式,并且适当地将它们移位,就会发现一个有13个相匹配的位的序列,用一串型号标识出来:
表示字符串
C语言中字符串被编码为一个以null(其值为0)字符结尾的字符数组。每个字符都由某个标准编码来表示,最常见的是ASCII字符码。
ASCII字符集合适合于编码英文文档,但是在表达一些特殊字符方面并没有太多办法。它完全不适合编码希腊语、俄语和中文等语言的文档。
基本编码,称为Unicode的“统一字符集”,使用32位来表示字符。这好像要求文本串中每个字符要占用4个字节。不过,可以有一些替代编码,常见的字符只需要1个或2个字节,而不太常用的字符需要多一些的字节。特别地,UTF-8表示将每个字符编码为一个字节序列,这样标注ASCII字符还是使用和它们在ASCII中一样的单字节编码,这也意味着所有的ASCII字节序列用ASCII码表示和用UTF-8表示是一样的。
对于中文环境,使用GBK编码存储中文字符串时,每个中文字符占用2字节,而使用UTF-8编码存储中文支付穿时,每个中文字符占用3字节。UTF-8是可变长度的编码方式,对于不同字符所占用的字节空间大小是可变的。
表示代码
不同的机器类型使用不同的且不兼容的指令和编码方式。即使是完全一样的进程,运行在不同的操作系统上也会有不同的编码规则,因此二进制代码是不兼容的。二进制代码很少能在不同机器和操作系统组合之间移植。
布尔代数简介
二进制值是计算机编码、存储和操作信息的核心,所以围绕数值0和1的研究已经演化出了丰富的数学知识体系。这起源于1850年前后乔治·布尔(George Boole,1815——1864)的工作,因此也称为布尔代数(Boolean algebra)。布尔注意到通过将逻辑值TRUE(真)和FALSE(假)编码为二进制1和0,能够设计出一种代数,以研究逻辑推理的基本原则。
最简单的布尔代数是在二元集合{0,1}基础上的定义。如图所示,定义了这种布尔代数中的几种运算。
位运算
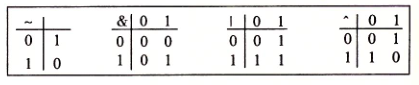
- 非:对单一变量的位取相反的位值,0的话取1,1的话取0
- 与:对两个变量进行与运算,同时为1才取值1,其他情况取值0
- 或:对两个变量进行或运算,只要有一个是1就取1,只有两个位同时为0才取0
- 异或:对两个变量进行异或运算,两个位相同取值0,不同则取值1
逻辑运算
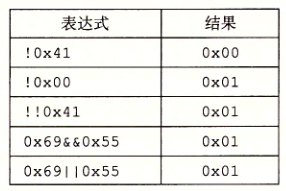
对应于位运算符的~、|和&,C语言还提供了一组逻辑运算符!、||、&&。虽然位运算和逻辑运算很相似,但它们是完全不同的功能。逻辑运算的结果只有true和false两种(即1和0),而不会计算位值。在C语言逻辑运算中,0表示false,而所有非0的都表示true。如图示例:
逻辑运算符&&和||与它们对应的位级运算&和|之间第二个重要的区别是,如果对第一个参数求值就能确定表达式的结果,那么逻辑运算符就不会对第二个参数求值。例如,表达式a&&5/a将不会造成被零除(因为如果a为0,&&之前就为false,不会继续往下执行),同理,p&&*p++也不会导致间接引用空指针(因为如果p为null空指针,即为false,那么也不会再往下执行求值)。
位移运算
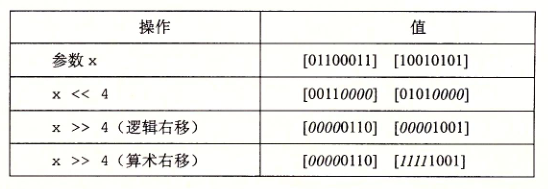
移位运算,可以是左位移,也可以是右位移。而位移量可以超过变量本身的位数(所占用的位大小),但最终C语言会通过求余的方式,将位移限制在其本身的位数上。例如一个32位的int类型,左移32位,则相当于左移0位;左移36位,则相当于左移4位;左移40位,则相当于左移8位。左移位数求值公式是左移位数%变量本身的位数,即求余。同理,右移也是如此。
在C语言中,右移位也分为算术右移和逻辑右移,常见的C语言编译器默认情况下均是算术右移。那什么是算术右移和逻辑右移的区别是什么呢?
我们先来说逻辑右移,逻辑右移是不管负数、零、还是正数,它都会直接把存在内存中的位直接右移,然后前边补0,得到最终结果。
然后来说算术右移,算术右移是会鉴别负数、零、还是正数的。对于正数和零,它与逻辑右移没有区别。而对于负数(最高位是1),右移相应的位数后,前边不再是填充0,而是填充1。
与C相比,Java对于如何进行右移有明确的定义。表达式是x>>k会将x算术右移k个位置,而x>>>k会对x做逻辑右移。
另外,在提一下移位运算的优先级,在C语言中,加法(和减法)的优先级是比移位运算要高的。
本节“信息存储”到此结束了。下一节,我们再来学习一下“整数表示”。