深入理解计算机系统学习笔记-第1章
条评论本篇文章是对《深入理解计算机系统(第三版)》的学习笔记,对一些重点概念和图表做记录,以及写下一些自己的理解,从而使自己更轻松的掌握这门知识。通过对这本书的深入学习,并且完全理解底层计算机系统以及它对应用程序的影响,那么离成为“大牛”就不远了:
- 该教材系统地介绍了整个计算机系统的工作原理,可帮助学生系统性地理解计算机如何执行程序、存储信息和通信;
- 该教材非常强调实践,全书包括9个配套的实验,在这些实验中,学生需要攻破计算机系统、设计CPU、实现命令行解析器、根据缓存优化程序等,在新鲜有需的实验中理解系统原理,培养动手能力;
- 该教材紧跟时代的发展,加入了x86-64指令集、Intel Core i7的虚拟地址结构、SSD磁盘、IPv6等新技术内容;
- 该教材从程序员的角度看待计算机系统,重点讨论系统的不同结构对于上层应用软件编写、执行和数据存储的影响,以培养程序员在更广阔空间应用计算机系统知识的能力。
计算机系统漫游
计算机系统是由硬件和系统软件组成的,它们共同工作来运行应用程序。
本教材在linxu系统下,通过C语言演示一些重要思想和实践过程,如下,是C语言的一个HelloWorld程序。
1 | // hello.c |
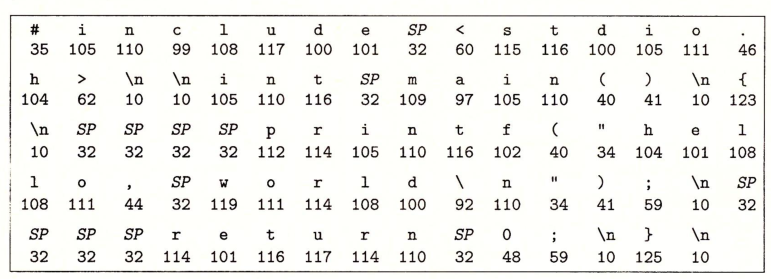
在hello.c文件中存储着上边可读的源代码,这是经过机器翻译并显示出来的。而实际该文件存储的是一系列的二进制数值,由ASCII码标准来表示的文本字符(当然,在现代计算机操作系统中,如果是中文环境的话通常使用GBK、UTF-8、UNICODE等编码格式)。
信息就是位+上下文
hello.c的表示方法说明一个基本思想:系统中所有的信息———包括磁盘文件、内存中的程序、内存中存放的用户数据以及网络上传送的数据,都是由一串比特表示的。区分不同数据对象的唯一方法是我们读到这些数据对象时的上下文。比如,在不同上下文中,一个同样的字节序列可能表示一个整数、浮点数、字符串或者机器指令。
用计算机表示的数字,其实是与实际的整数、实数是不相同的。计算机表示的数字,是对真值的有限近似值。
程序被其他程序翻译成不同的格式
hello(不带后缀)程序的生命周期是从一个高级C语言程序开始的。即,从编写源码开始,到预处理,到编译,到汇编,最后到链接,分别经过了文本/代码编辑器、预处理器cpp、编译器ccl、汇编器as、链接器ld等。
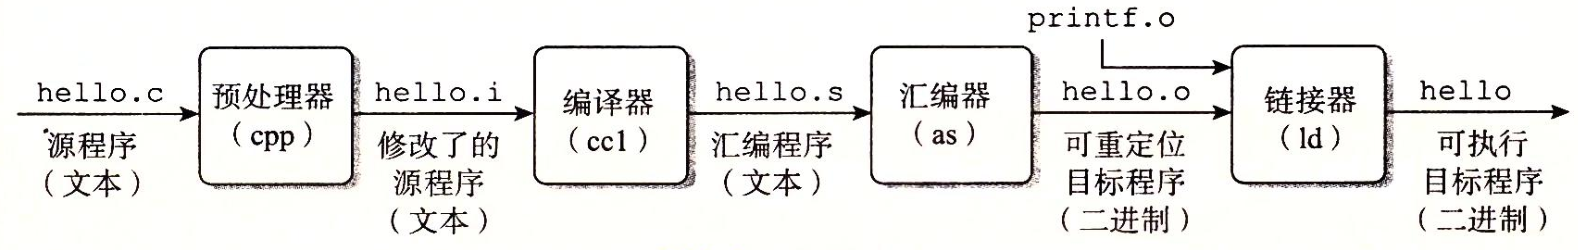
- 预处理阶段。预处理器根据以字符#开头的命令,修改原始的C程序源码。比如,hello.c中第1行的
#include <stdio.h>命令告诉预处理器读取系统头文件stdio.h的内容,并把它直接插入程序文本中。结果就得到了另一个C程序源码,通常是以.i作为文件扩展名。 - 编译阶段。编译器将文本文件hello.i翻译成文本文件hello.s,它是一个汇编语言程序源码。翻译成汇编语言的其中一个作用是,让C语言兼容其他高级语言,因为其他高级语言可能也会按照规范,将自己翻译成汇编语言。
- 汇编阶段。接下来,汇编器将hello.s翻译成机器语言指令,并将结果保存在目标文件hello.o中。hello.o文件是一个二进制文件,它包含的17个字节是函数main的指令编码。
- 链接阶段。请注意,hello程序调用了printf函数,它是每个C编译器都提供的标准C库中的一个函数。printf函数存在于一个名为printf.o的单独的预编译好了的目标文件中,而这个文件必须以某种方式合并到我们的hello.o程序中。链接器就负责处理这种合并。结果就得到hello文件,它是一个可执行目标文件(或者简称为可执行文件),可以被加载到内存中,由系统执行。
了解编译系统如何工作是大有益处的
我们在实际开发过程中,可能会因为一些原因使得我们必须了解编译系统是如何工作的,例如:
- 优化程序性能
- 理解链接时出现的错误
- 避免安全漏洞
处理器读并解释存储在内存中的指令
1 | linux> ./hello |
经过编译系统的编译后,生成了我们的可执行程序hello,并存放在磁盘中。在linux操作系统的shell中,执行hello程序。此时我们就会看到输出printf所输出的字样,并且在输出完毕后,shell会返回继续等待下一个输入的命令行。
系统的硬件组成
一个典型的计算机系统通常包含总线、I/O设备、主存、处理器等部件。
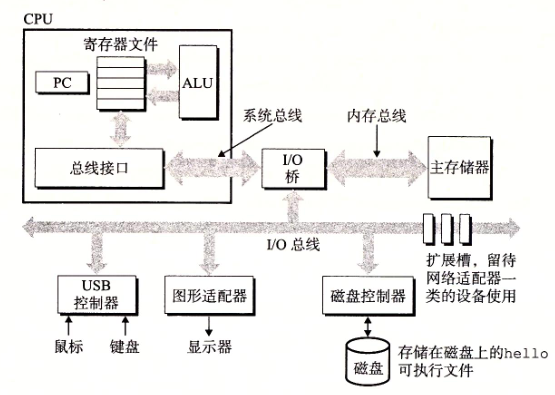
- 总线通常被设计成传送定长的字节块,也就是字(word)。目前流行的计算机系统有4字节(32位)的,也有8字节(64位)的。
- I/O设备是多种多样的,网络也可作为一个I/O,每个I/O设备都是通过一个控制器或适配器与I/O总线相连的(控制器或适配器可能是独立的,也可能被集成到主板芯片组或I/O设备本身)。
- 主存,即我们俗称的内存条,是一个临时存储设备,在处理器执行程序时,用来存放程序和程序处理的数据。物理上,由一组动态随机存储器(DRAM)芯片组成。逻辑上,是一个线性的字节数组,每个字节都有其唯一的地址(数组索引),这些地址是从零开始的。
- 处理器,即中央处理单元(CPU),是解释(或执行)存储在主存中指令的引擎。CPU内部通常包含有程序计数器(PC)、算数/逻辑单元(ALU)、寄存器文件等,另外为了加速CPU读写速度,在现代CPU中,还有其内部的缓存。
回过头来,再看hello程序的执行过程:
- 输入
./hello时,shell程序会将输入的字符逐一读入寄存器,再把它存放到主存中。 - 按下
回车键时,shell程序开始执行系列指令来加载可执行程序hello文件,操作系统就会使用直接存储器存取(DMA)技术,使hello文件不经过CPU而直接被加载到主存中。 - 一旦完成hello的主存加载,CPU将会执行hello程序的main函数的机器语言指令,将
Hello, World!字符串中的字节从主存复制到寄存器文件,再从寄存器文件中复制到显示设备,最终显示在屏幕上。
高速缓存至关重要
在上面的hello执行示例中,有一个很重要的问题,就是系统在执行hello程序时,大量的时间被消耗在把信息从一个地方挪到另一个地方。首先是从磁盘读写到主存,接着在执行过程中,指令又从主存复制到CPU,还有屏幕打印出“Hello, World!”字样,从CPU到主存再到显示器I/O设备,信息搬运的过程是极其消耗时间的。
根据机械原理,较大的存储设备要比较小的存储设备运行慢,而快速设备的造价远高于同类的低速设备。
随着半导体技术的进步,处理器和主存之间的差距还在持续增大(因为加快处理器的运行速度比加快主存的运行速度要容易和便宜得多)。
为了弥补处理器和主存之间的读写速度差距,在现在的CPU设计中加入了高速缓存存储器,简称cache或高速缓存,作为暂时的集结区域,存放处理器近期可能会需要的信息。
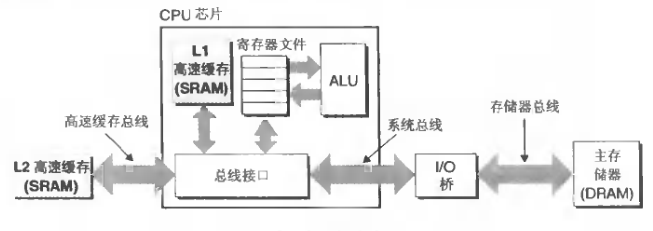
如图所示,是CPU芯片上的L1高速缓存,访问速度和寄存器一样块。另外,还有L2高速缓存,在CPU芯片外,通过一条特殊的总线连接到处理器。L1和L2高速缓存是用一种叫做静态随机访问存储器(SRAM)的技术实现的。这也是我们在购买CPU时,其参数所示的一级缓存、二级缓存。
存储设备形成层次结构
在处理器和一个较大较慢的设备(例如主存)之间插入一个更小更快的存储设备(例如高速缓存)的想法已经成为一个普遍的观念。实际上,每个计算机系统中的存储设备都被组织成了一个存储器层器结构。
在这个层次结构中,从上至下,设备的访问速度越来越慢、容量越来越大,并且每字节的造价也越来越便宜。寄存器文件在层次结构中位于最顶部,也就是第0级或记为L0。这里我们展示的是三层高速缓存L1到L3,占据存储器层次结构的第1层到第3层。主存在第4层,以此类推。
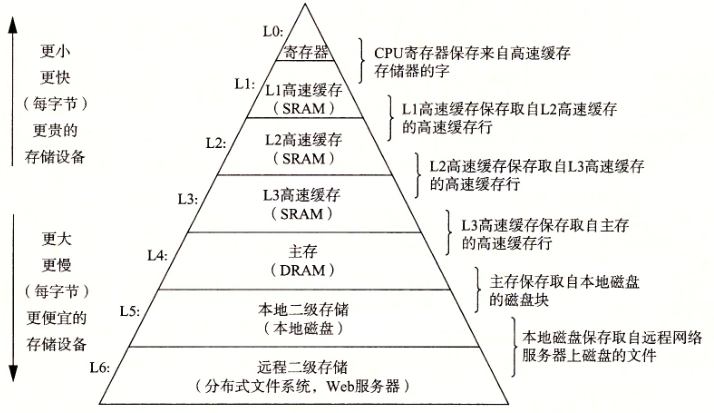
存储器层次结构的主要思想是上一层的存储器作为低一层存储器的高速缓存。因此,寄存器文件是L1的高速缓存,L1是L2的高速缓存,L2是L3的高速缓存,L3是主存的高速缓存,而主存又是磁盘的高速缓存。在某些具体分布式文件系统的网络系统中,本地磁盘就是存储在其他系统中磁盘上的数据的高速缓存。
操作系统管理硬件
操作系统有两个基本功能:
- 防止硬件被失控的应用程序滥用
- 向应用程序提供简单一致的机制来控制复杂而又通常大不相同的低级硬件设备。
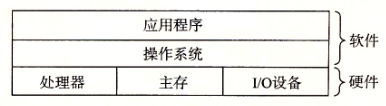
如图计算机系统的分层视图所示,所有应用程序对硬件的操作尝试都必须通过操作系统。
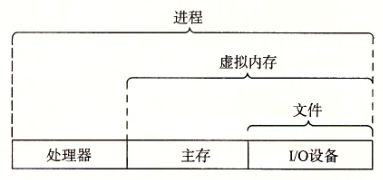
操作系统通过以下几个基本的抽象概念来实现防止失控和一致性的这两个功能。如操作系统提供的抽象表示图所示:
- 文件是对I/O设备的抽象表示
- 虚拟内存是对主存和磁盘I/O设备的抽象表示
- 进程是对处理器、主存和I/O设备的抽象表示
进程
进程是操作系统对一个正在运行的程序的一种抽象。操作系统能够并发运行多个进程。
操作系统保持跟踪进程运行所需的所有状态信息。这种状态,也就是上下文,包括许多信息,比如PC和寄存器文件的当前值,以及主存的内容。在任何一个时刻,单处理系统都只能执行一个进程的代码。
当操作系统决定要把控制权从当前进程转移到某个新进程时,就会进行上下文切换,即保存当前进程的上下文、恢复新进程的上下文,然后将控制权传递到新进程。此时,新进程就会从它上次停止的地方开始。
从一个进程到另一个进程的转换,是由操作系统内核(kernel)管理的。内核是操作系统代码常驻主存的部分。
当应用程序需要操作系统的某些操作时,比如读写文件,它就执行一条特殊的系统调用(system call)指令,将控制权传递给内核。
内核不是一个独立的进程。相反,它是系统管理全部进程所用代码和数据结构的集合。
线程
在现代系统中,一个进程实际上可以由多个成为线程的执行单元组成,每个线程都运行在进程的上下文中,并共享同样的代码和全局数据。
虚拟内存
虚拟内存是一个抽象概念,它为每个进程提供了一个假象,即每个进程都在独占地使用主存。每个进程看到的内存都是一致的,称为虚拟地址空间。
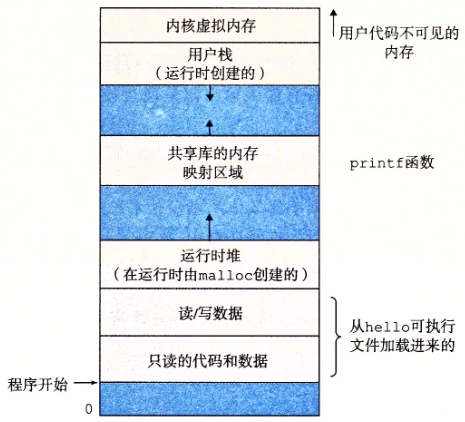
在Linux中,地址空间最上面的区域是保留给操作系统中的代码和数据的,这对所有进程来说都是一样的。地址空间的底部区域存放用户进程定义的代码和数据。
每个进程看到的虚拟地址空间由大量准确定义的区域构成,每个区域都有专门的功能。如上图所示,我们从最低的地址开始,逐步向上介绍:
- 程序代码和数据。对所有的进程来说,代码是从同一固定地址开始,紧接着的是和C全局变量相对应的数据位置。代码和数据区是直接接按照可执行程序目标文件的内容初始化的。
- 堆。代码和数据区后紧随着的是运行时堆。代码和数据区在进程一开始运行时就被指定了大小,与此不同,当调用像malloc和free这样的C标准库函数时,堆可以在运行时动态地扩展和收缩。
- 共享库。大约在地址空间的中间部分是一块用来存放像C标准库和数学库这样的共享库的代码和数据的区域。
- 栈。位于用户虚拟地址空间顶部的是用户栈,编译器用它来实现函数调用。和堆一样,用户栈在程序执行期间可以动态地扩展和收缩。特别地,每次我们调用一个函数时,栈就会增加;从一个函数返回时,栈就会收缩。
- 内核虚拟内存。地址空间顶部的区域是为内核保留的。不允许应用程序读写这个区域的内容或者直接调用内核代码定义的函数。相反,它们必须调用内核来执行这些操作。
文件
文件就是字节序列。每个I/O设备,包括磁盘、键盘、显示器,甚至网络,都可看成是文件。系统中的所有输入输出都是通过使用一小组成为Unix I/O的系统函数调用读写文件来实现的。
系统之间利用网络通信
网络可视为一个I/O设备。
重要主题
系统不仅仅只是硬件。系统是硬件和系统软件互相交织的集合体,它们必须共同协作以达到运行应用程序的最终目的。
Amdahl定律
Gene Amdahl,计算领域的早期先锋之一,对提升系统某一部分性能所带来的效果做出了简单却有见地的观察。这个观察被称为Amdahl定律(Amdahl’s law)。该定律的主要思想是,当我们对系统的某个部分加速时,其对系统整体性能的影响取决于该部分的重要性和加速程度。同样的,要想显著加速整个系统,必须提升全系统中相当大的部分的速度。
1 | S=Told/Tnew |
上述是计算加速比S的公式,其中Told表示系统执行应用程序需要的时间,Tnew表示经过性能优化后系统执行应用程序需要的时间。a表示应用中某部分所需的执行时间aTold与Told的比,k表示该部分性能的提升比例。
并发和并行
两个驱动力:一个是我们想要计算机做得更多,另一个是我们想要计算机运行得更快。
- 并发,是一个通用的概念,指一个同时具有多个活动的系统。
- 并行,指的是用并发来使一个系统运行得更快。并行可以在计算机系统的多个抽象层次上运用。
我们按照系统层次结构中由高到低的顺序重点强调三个层次。
- 线程级并发
在以前,及时处理器必须在多个任务间切换,大多数实际的计算也都是由一个处理器来完成的,这种配置称为单处理器系统。
当构建一个由单操作系统内核控制的多处理器组成的系统时,我们就得到了一个多处理器系统。
超线程,有时也称同时多线程,是一项允许一个CPU执行多个控制流的技术。也就是我们平时所说的2核4线程或者4核8线程之类的说法。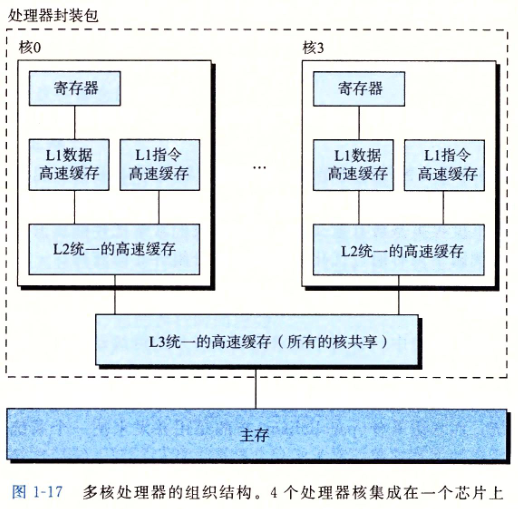
- 指令级并行
在较低的抽象层次上,现代处理器可以同时执行多条指令的属性成为指令级并行。
其实每条指令从开始到结束需要长得多的时间,大约20个或者更多周期,但是处理器使用了非常多的聪明技巧来同时处理多达100条指令。
在流水线(pipelining)中,将执行一条指令所需要的活动划分成不同的步骤,将处理器的硬件组织成一系列的阶段,每个阶段执行一个步骤。这些阶段可以并行地操作,用来处理不同指令的不同部分。
如果处理器可以达到比一个周期一条指令更快的执行速率,就称之为超标量(super-scalar)处理器。 - 单指令、多数据并行
在最低层次上,许多现代处理器拥有特殊的硬件,允许一条指令产生多个就可以并行执行的操作,这种方式成为单指令、多数据,即SIMD并行。
GCC支持向量数据类型。
计算机系统中抽象的重要性
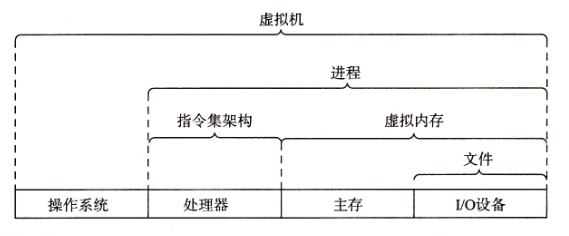
抽象的使用是计算机科学中最为重要的概念之一。如图所示,在处理器里,指令级架构提供了对实际处理器硬件的抽象。使用这个抽象,机器代码程序表现得就好像运行在一个一次只执行一条指令的处理器上。底层的硬件远比抽象描述的要复杂精细,它并行地执行多条指令,但又总是与那个简单有需的模型保持一致。只要执行模型一样,不同的处理器实现也能执行同样的机器代码(如x86-64指令集),而又提供不同的开销和性能。